제주 바이오기업 AI/AX 및 바이오 AI센터 역량강화 특강 · 기록
노트북의 AI와
센터의 AI
“챗GPT 쓰면 되는 거 아닌가요?” — 2026년 12월, 제주대 후문에 AI 데이터센터가 들어섭니다. 무엇이 다르고, 누가 어떻게 쓰면 되는지 두 번의 교육에서 공개된 내용으로 정리했습니다.
“챗GPT 쓰면 되는 거 아닌가요?” — 2026년 12월, 제주대 후문에 AI 데이터센터가 들어섭니다. 무엇이 다르고, 누가 어떻게 쓰면 되는지 두 번의 교육에서 공개된 내용으로 정리했습니다.
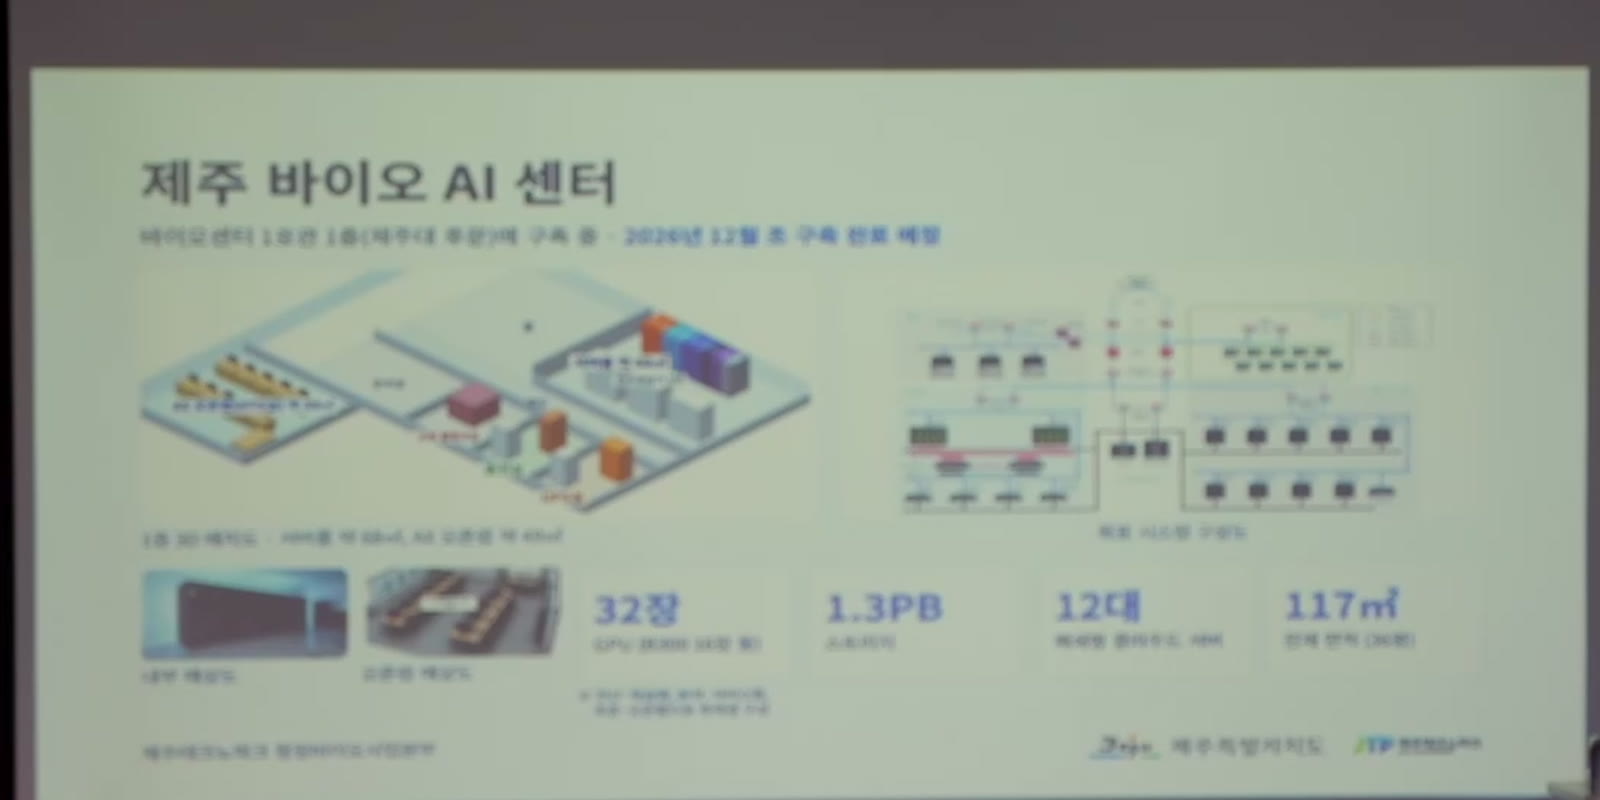
제주테크노파크가 제주대 후문 바이오센터 1호관 1층에 AI 데이터센터를 짓고 있습니다. 2026년 12월 초 구축 완료 예정입니다.
쓰는 길은 두 갈래 — 연산 자원을 빌려 직접 만들거나, 만들어진 AI 서비스를 골라 쓰거나.
다만 운영방식 · 이용조건 · 이용료 · 자원 배정방식은 아직 정해지지 않았습니다. 향후 운영계획에 따라 결정된다고 발표 자료에 적혀 있습니다.
발표 자료에 공개된 수치입니다. 1층에 서버룸과 AX 오픈랩이 나란히 들어갑니다.
맞습니다. 많은 일은 그걸로 됩니다. 그런데 센터가 필요한 일은 결이 다릅니다. 한 문장으로 줄이면 이렇습니다.
챗GPT나 클로드에 물어보는 것은 이미 다 만들어진 모델을 쓰는 일입니다. 전문 용어로는 추론(inference)이라고 합니다. 질문 하나에 계산이 한 번 지나가니 노트북에서도 됩니다 — 정확히는, 계산은 저쪽 회사의 서버가 하고 우리는 결과만 받습니다.
반면 우리 회사 데이터로 모델을 새로 만드는 일은 학습(training)입니다. 이건 계산이 한 번으로 끝나지 않습니다.
계산이 한 번 지나간다
노트북으로 충분
같은 계산을 끝없이 되풀이
이 고리를 수만 번
왼쪽은 한 번, 오른쪽은 수만 번. GPU가 필요해지는 자리는 오른쪽입니다.
학습은 ① 자료를 준비하고 ② 예측해 보고, 정답과 비교하고, 틀린 만큼 내부 수치를 조금 고치고 — 이걸 되풀이한 다음 ③ 따로 떼어 둔 데이터로 성능을 확인하는 과정입니다. 2차 특강은 이걸 요리에 빗댔습니다.
쓸 데이터를 모으고 정리한다
예측 → 정답 비교 → 내부 가중치 조정, 반복
학습에 쓰지 않은 데이터로 정확도 확인
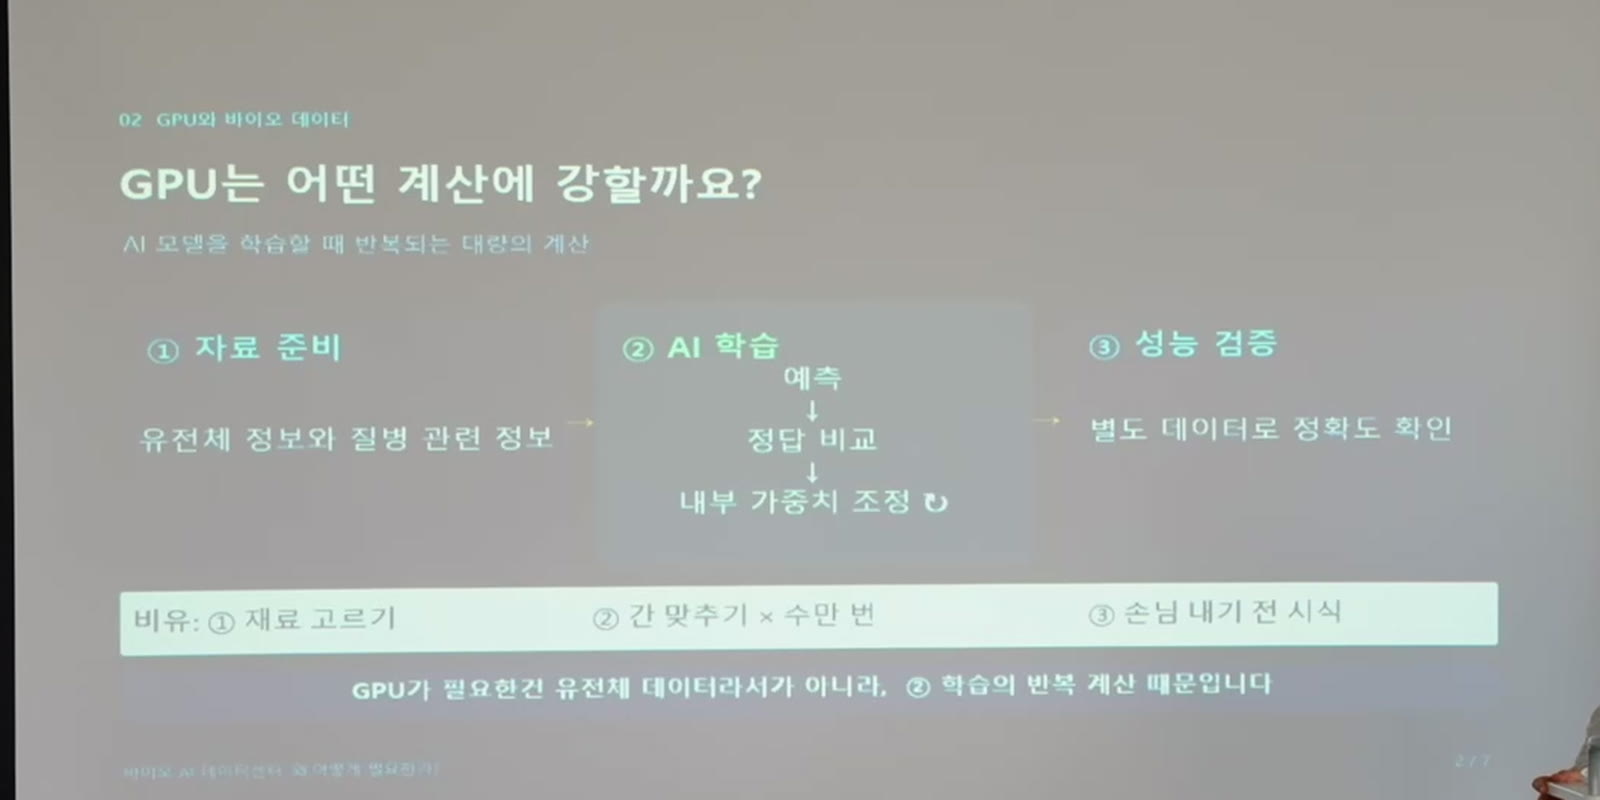
GPU는 똑같은 모양의 계산을 한꺼번에 수천 갈래로 펼쳐서 처리하는 데 특화된 장치입니다. 사람이 한 줄로 서서 차례로 계산하는 게 CPU라면, GPU는 수천 명이 나란히 서서 같은 계산을 동시에 하는 쪽입니다. 학습이 바로 그런 모양의 계산이라 잘 맞습니다.
| 노트북 · 사무실 PC | GPU 꽂은 워크스테이션 | AI 데이터센터 | |
|---|---|---|---|
| 주로 하는 일 | 만들어진 AI를 쓴다 | 작은 모델을 만들어 본다 | 큰 데이터로 제대로 만든다 |
| 한 번에 올릴 수 있는 데이터 | 아주 작게 | 장비 메모리만큼 | 여러 장을 묶어서 크게 |
| 며칠짜리 계산 | 사실상 못 한다 | 밤새 돌린다 | 나눠서 돌린다 |
| 데이터가 있는 곳 | 내 PC · 외부 서비스 | 우리 사무실 | 폐쇄형 환경 |
| 장비 관리 | 내가 | 우리 회사가 | 센터가 |
| 발표 자료의 비유 | 택시 | 자가용 | 렌터카 |
메모리가 먼저 막힙니다. 학습에서는 모델의 파라미터, 역전파에 쓸 중간값, 옵티마이저 상태가 전부 GPU 메모리에 올라가 있어야 합니다. 계산이 느린 게 문제가 아니라 아예 올라가지 않아서 시작을 못 하는 경우가 흔합니다. 장수가 늘면 모델과 데이터를 여러 장에 나눠 얹을 수 있고, 그제야 돌릴 수 있는 크기가 달라집니다.
배치 크기가 품질을 바꿉니다. 메모리가 좁으면 한 번에 보는 표본 수를 줄여야 하고, 그만큼 학습이 불안정해지거나 더 많은 반복이 필요해집니다. 같은 하루를 써도 결과가 달라지는 이유입니다.
데이터가 밖으로 나가지 않습니다. 외부 AI 서비스에 올려서 푸는 방법도 있지만, 유전체·건강 정보처럼 반출 조건이 까다로운 데이터는 그 선택지가 막힙니다. 발표 자료에 적힌 폐쇄형 클라우드 서버 12대와 공통 운영관리의 데이터 보안 · 개인정보 보호 항목이 이 지점을 겨냥합니다.
나눠 쓰는 장치가 따로 있습니다. 공통 운영관리에 GPU 가상화 · 분할, 스케줄링 · 모니터링, 기업 · 사용자 접근권한이 들어가 있습니다. 32장을 한 회사가 통째로 쓰는 구조가 아니라, 수요에 맞춰 쪼개 배정하는 구조라는 뜻입니다. 다만 어떤 기준으로 얼마나 배정할지는 아직 공개되지 않았습니다.
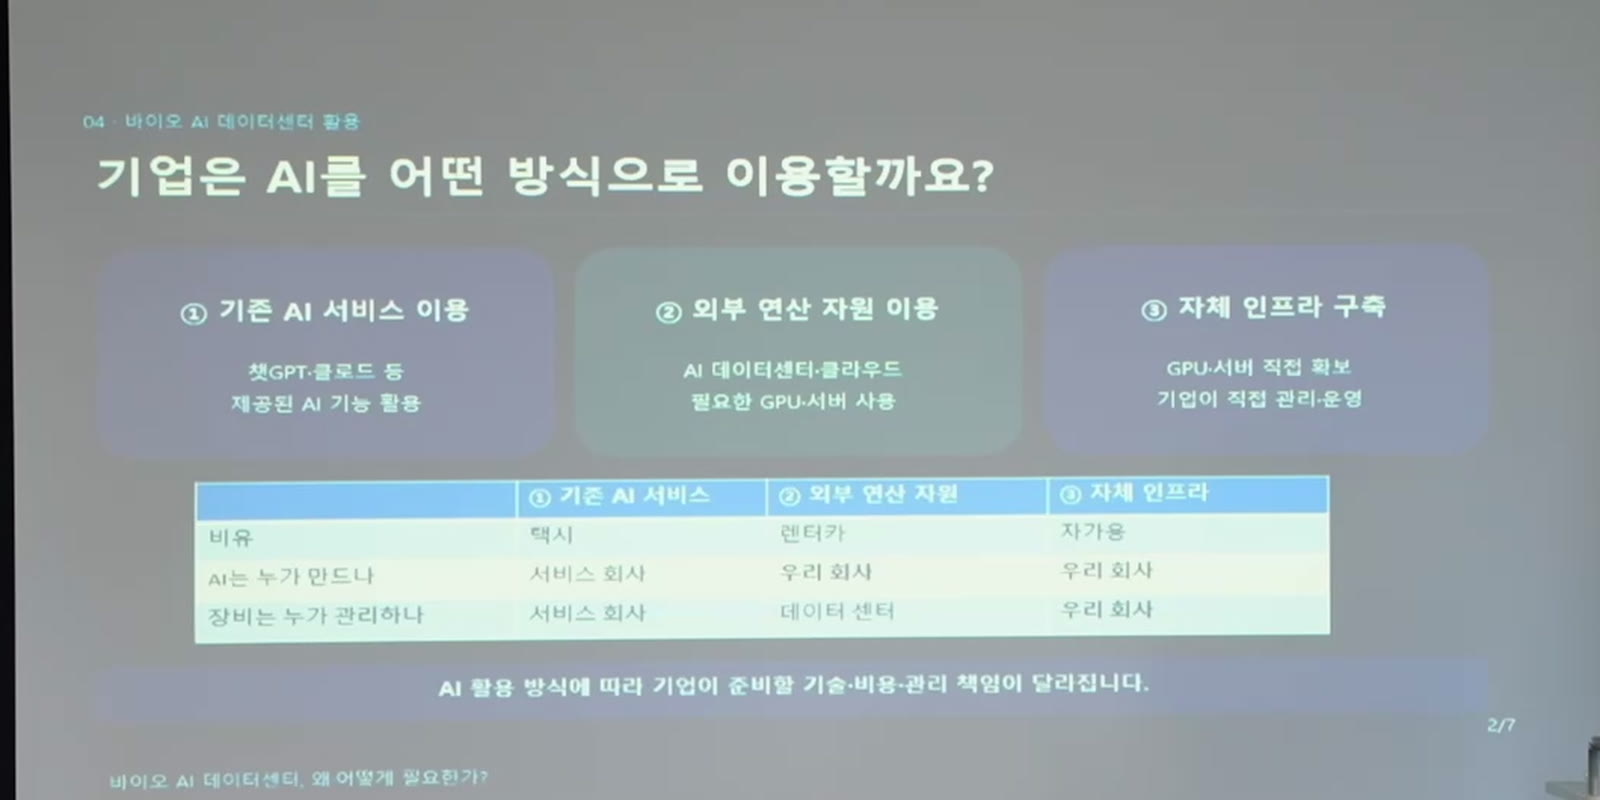
2차 특강은 이걸 교통수단에 빗대 갈랐습니다. 셋 중 어디가 맞는지는 회사가 무엇을 하려는지에 달려 있습니다.
챗GPT · 클로드 등 제공된 AI 기능 활용
AI 데이터센터 · 클라우드에서 필요한 GPU 서버를 쓴다
GPU · 서버를 직접 확보해 직접 운영
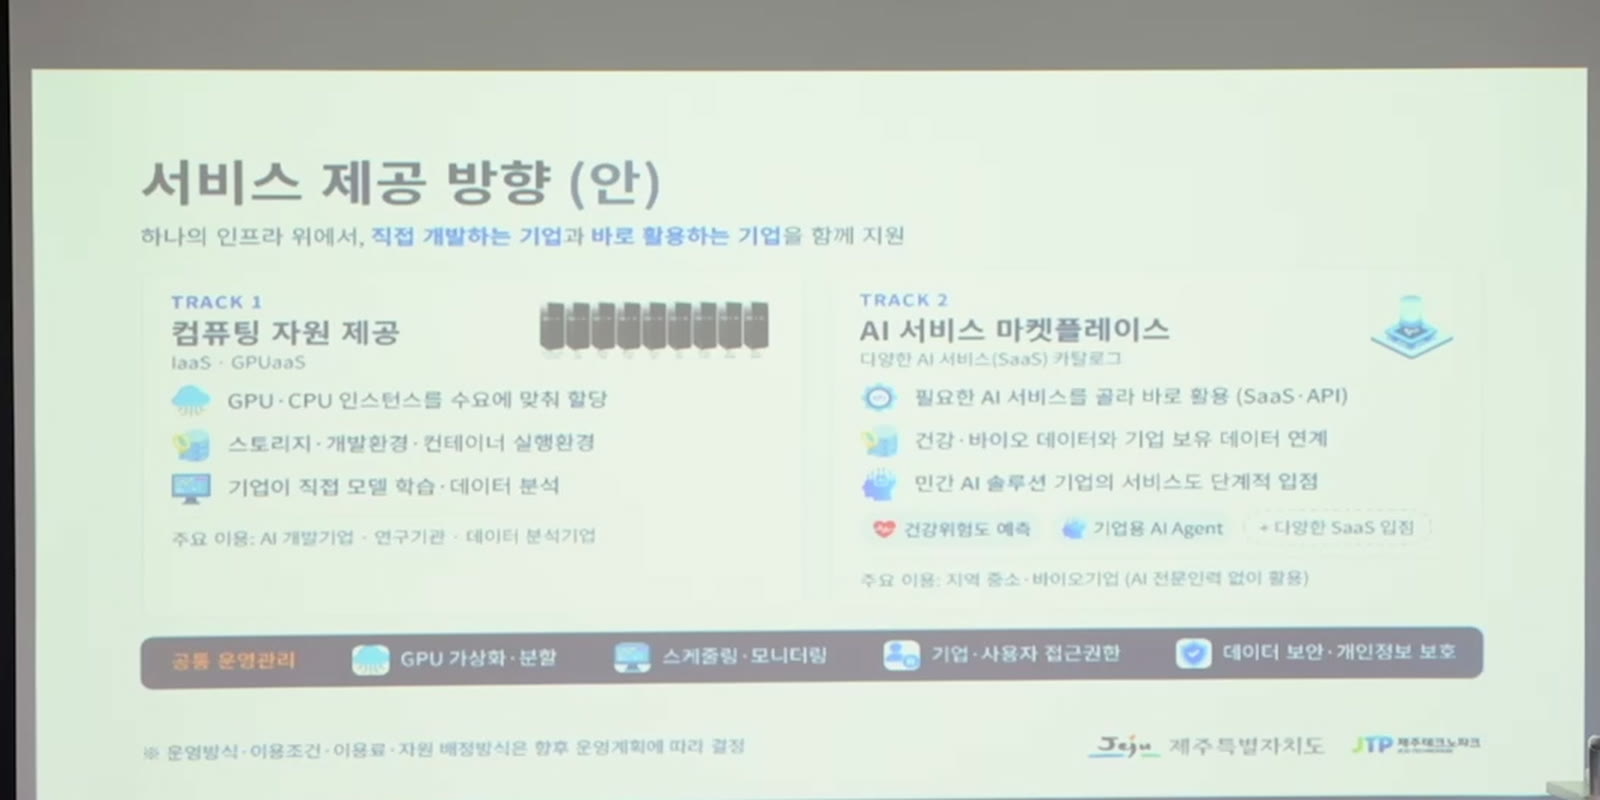
하나의 인프라 위에서 직접 개발하는 기업과 바로 활용하는 기업을 함께 받겠다는 구성입니다.
IaaS · GPUaaS
주요 이용 — AI 개발기업 · 연구기관 · 데이터 분석기업
다양한 AI 서비스(SaaS) 카탈로그
주요 이용 — 지역 중소 · 바이오기업 (AI 전문인력 없이 활용)
두 갈래 아래에 공통 운영관리가 깔립니다 — GPU 가상화 · 분할 / 스케줄링 · 모니터링 / 기업 · 사용자 접근권한 / 데이터 보안 · 개인정보 보호.
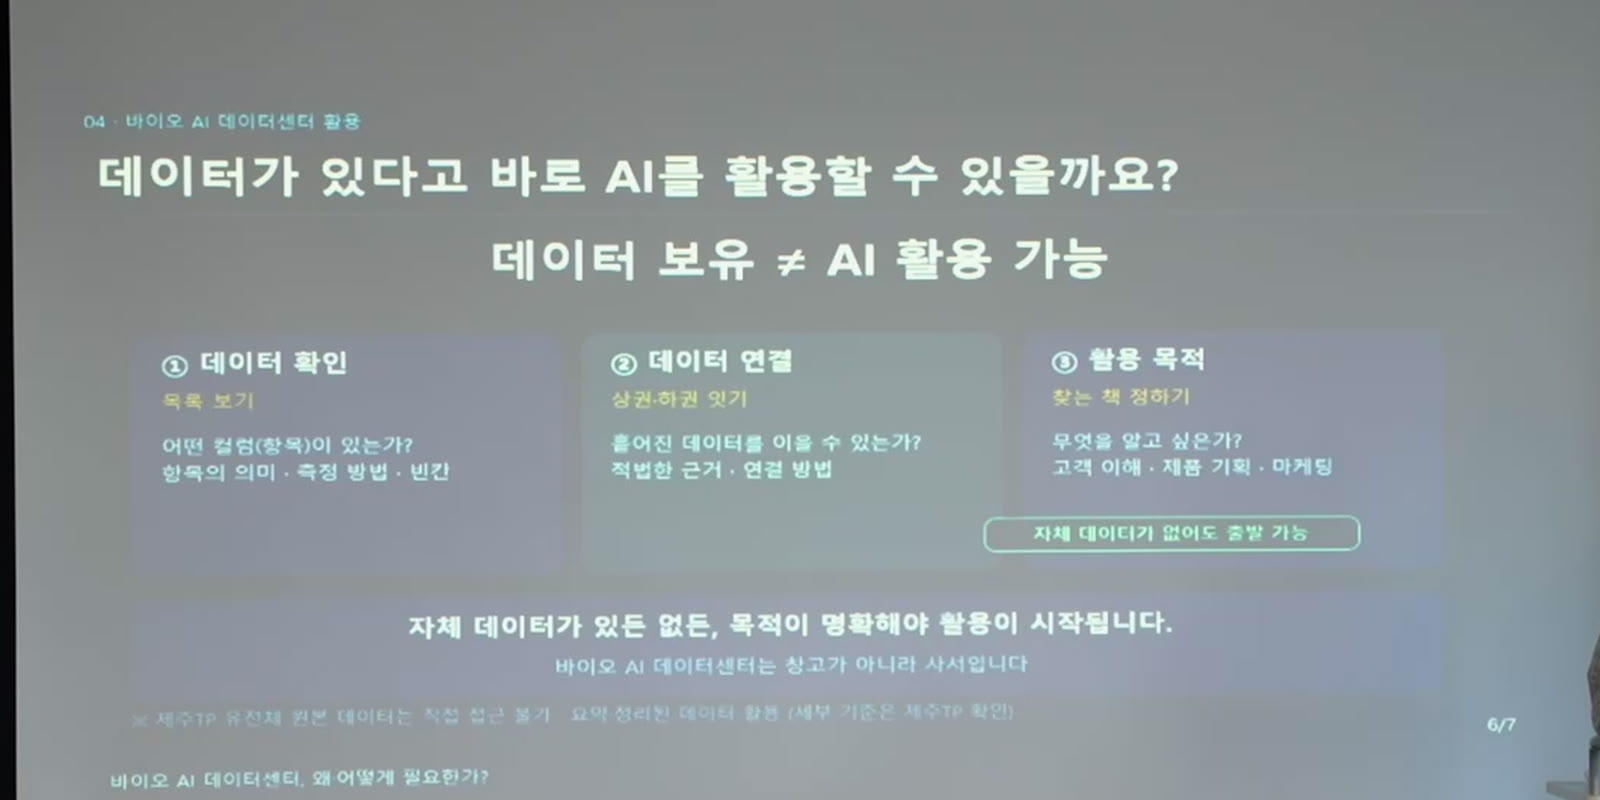
데이터를 쌓아 두는 곳이 아니라 작업하는 곳입니다. 자체 데이터가 있든 없든, 목적이 명확해야 활용이 시작됩니다.
센터는 연산 환경과 데이터 활용 기반을 제공합니다. 무엇을 풀지 정하고 모델을 만드는 일은 기업의 몫입니다.
AI가 잘 맞혔다고 해서 원인까지 알아낸 것은 아닙니다. 찾고 · 비교하고 · 예측하고 · 경보하는 데까지가 AI, 판단은 사람이 합니다.
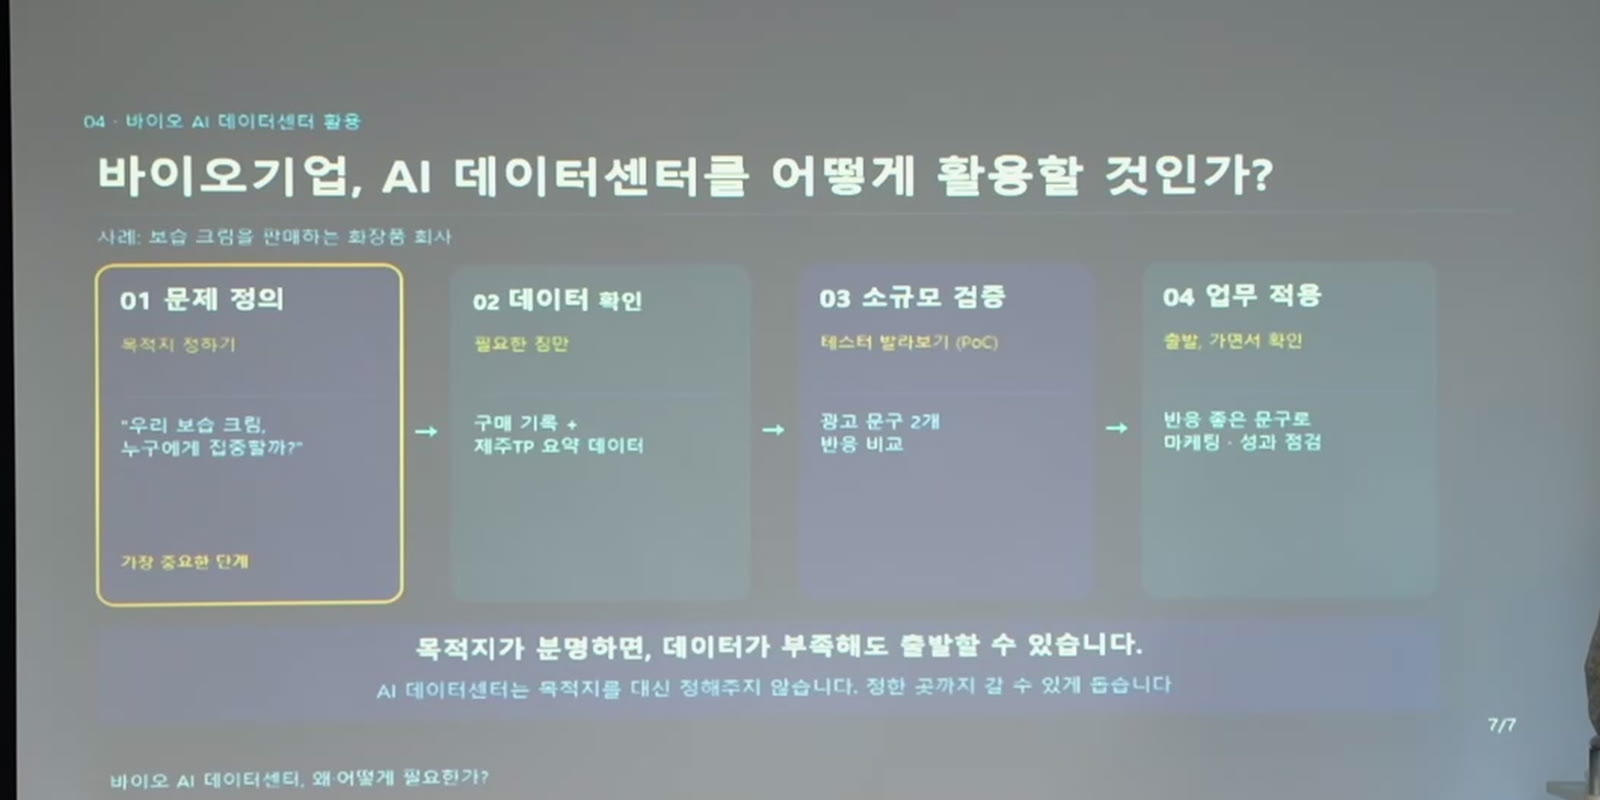
2차 특강이 제시한 순서입니다. 데이터부터 모으는 게 아니라 문제부터 정하는 것이 첫 칸입니다.
“우리 보습 크림, 누구에게 집중할까?” — 가장 중요한 단계
필요한 항목이 있는지, 어떤 데이터를 끌어올 수 있는지
작게 만들어 보고 비교 (PoC)
반응이 좋은 쪽으로 적용하고 성과를 점검
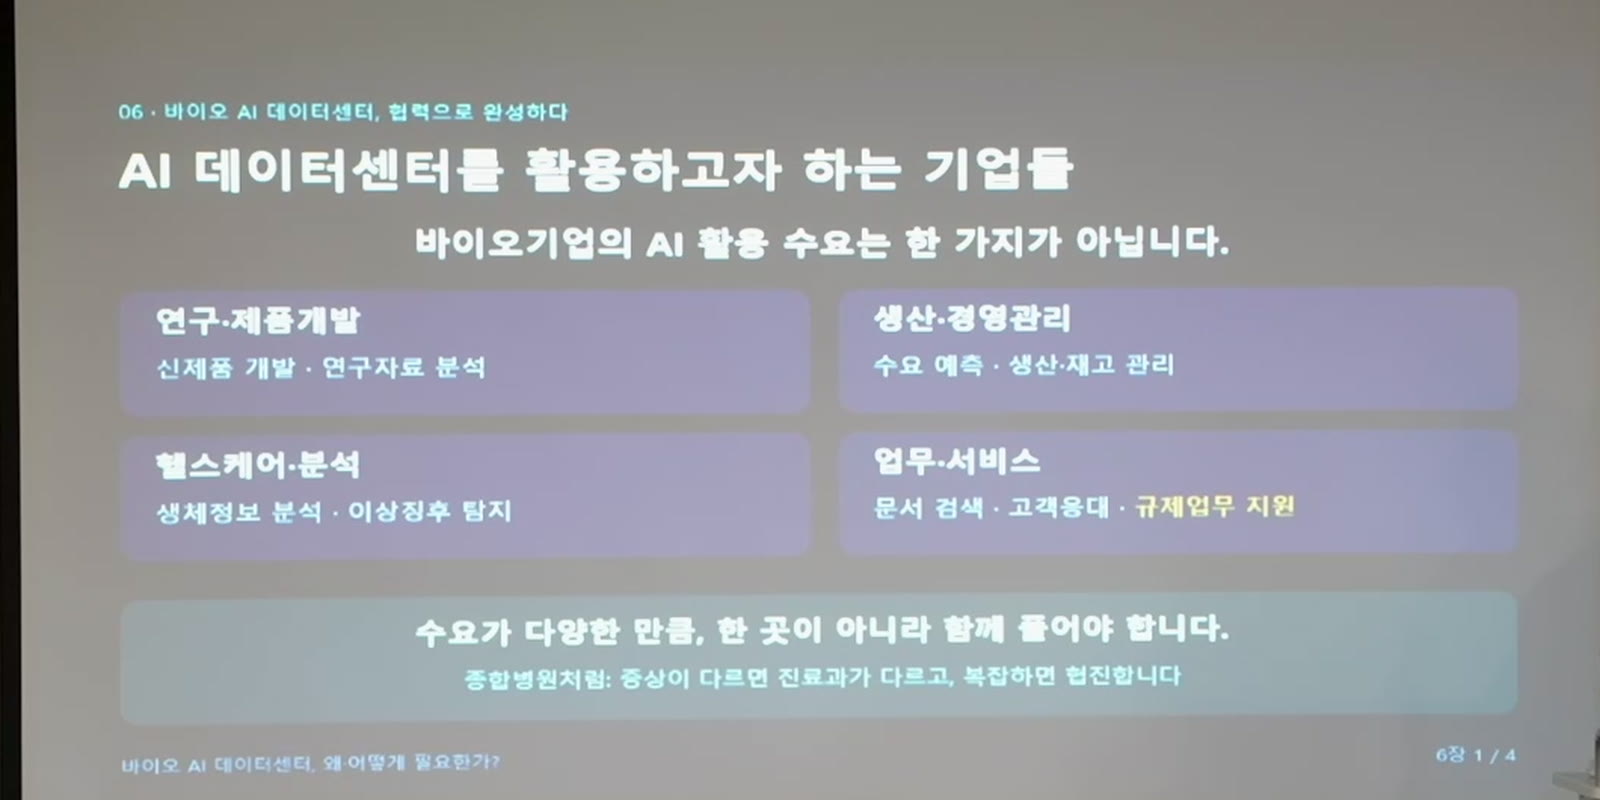
발표 자료는 바이오기업의 AI 활용 수요를 네 갈래로 갈랐습니다. “수요가 다양한 만큼, 한 곳이 아니라 함께 풀어야 한다”는 설명이 붙습니다 — 종합병원처럼 증상이 다르면 진료과가 다르고, 복잡하면 협진한다는 비유입니다.
성분과 효능, 논문과 실험 기록을 뒤져야 하는 쪽
판매 데이터가 쌓여 있는데 쓰지 못하고 있는 쪽
이미지나 측정값에서 패턴을 찾아야 하는 쪽
사람 손이 너무 많이 가는 반복 업무가 있는 쪽
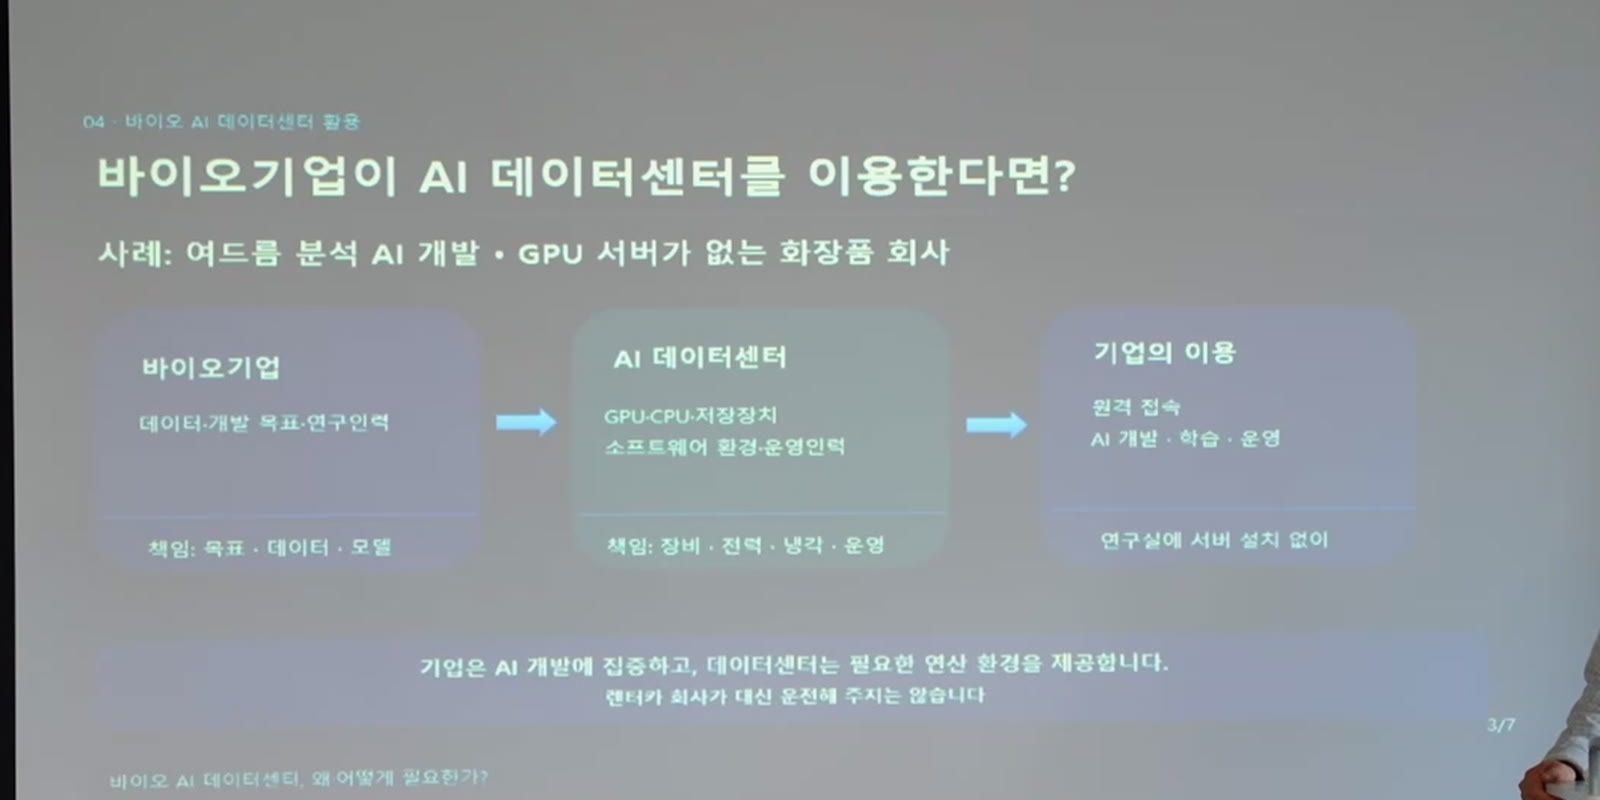
여드름을 분석하는 AI를 만들고 싶지만 연구실에 GPU 서버가 없는 회사를 예로 들었습니다. 회사는 데이터와 개발 목표, 연구 인력을 갖고 옵니다. 센터는 GPU · CPU · 저장장치와 소프트웨어 환경, 운영 인력을 댑니다. 회사는 연구실에 서버를 설치하지 않고 원격으로 접속해 AI를 개발 · 학습 · 운영합니다.
센터가 폐쇄형으로 설계되고 공통 운영관리에 보안 항목이 들어간 이유는 다루는 데이터의 성격 때문입니다.
주로 기업의 영업 · 운영 정보.
유출되면 — 바꾸거나 수정할 수 있다
개인의 신체적 · 건강상 특성과 연결.
유출되면 — 바꿀 수 없고, 가족까지 연결된다
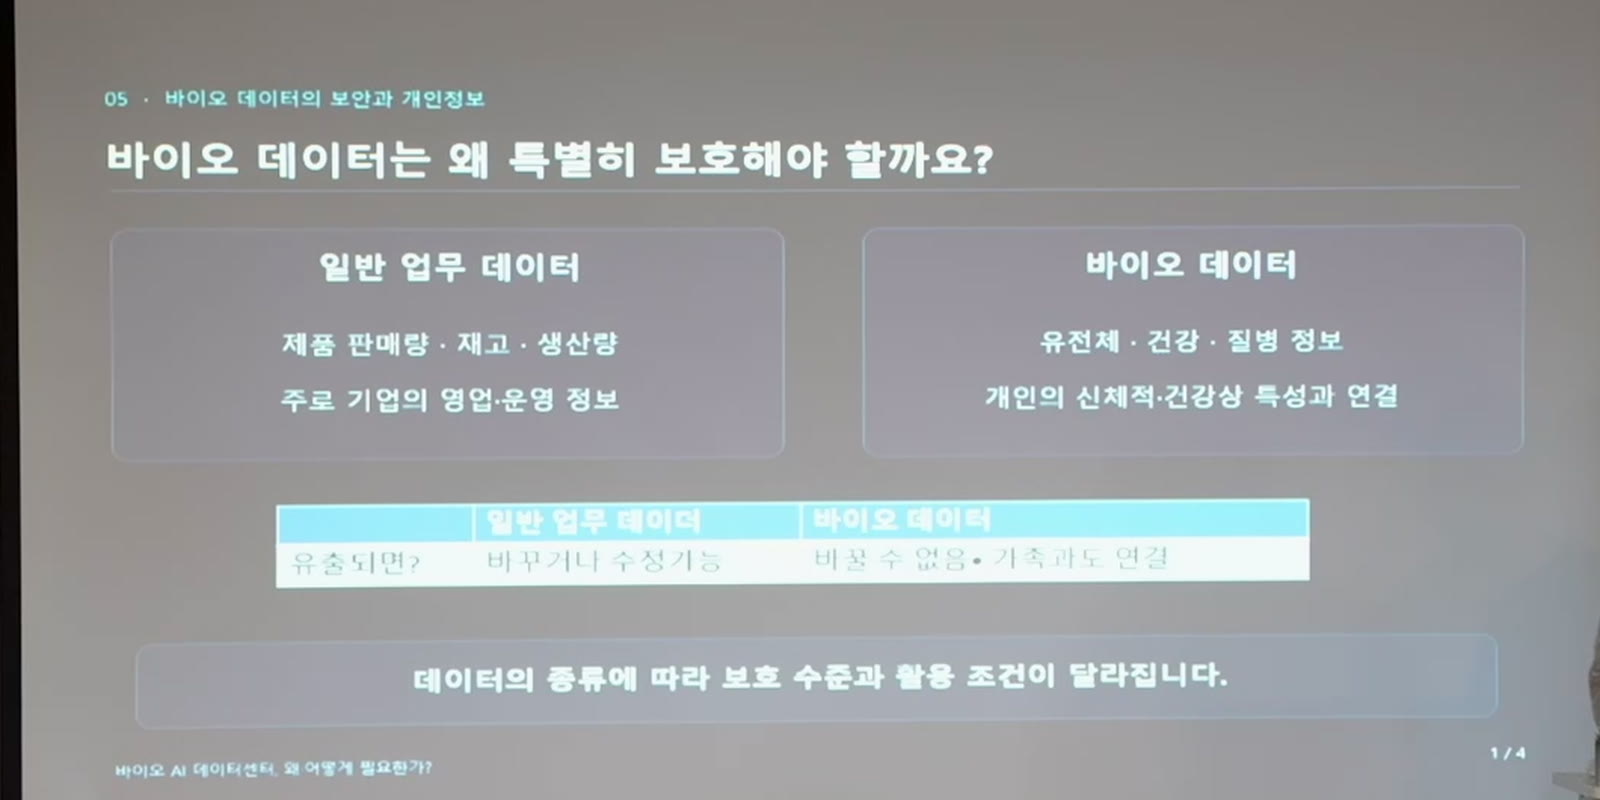
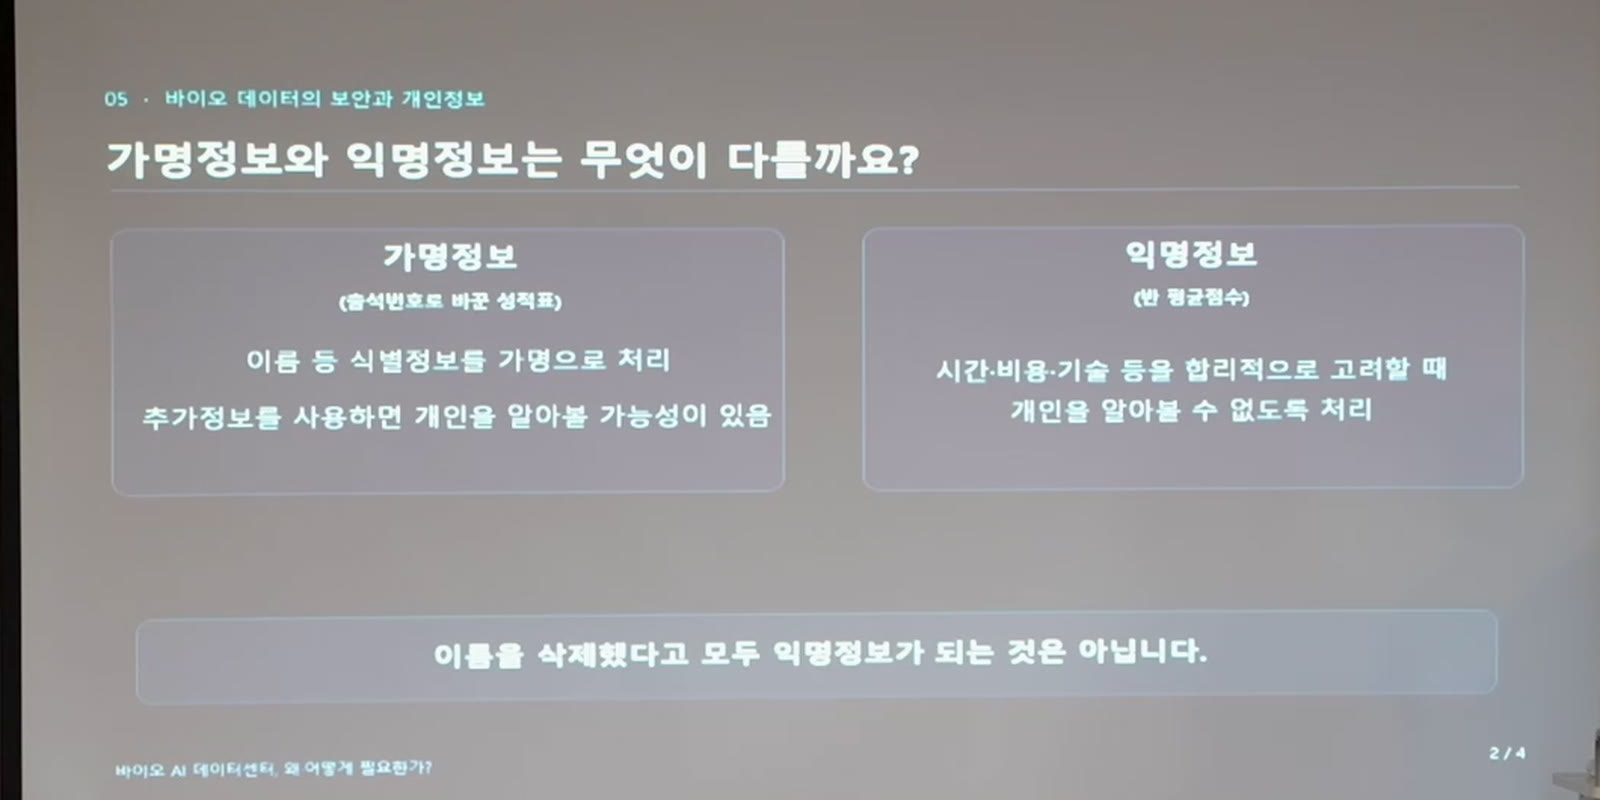
그래서 “데이터의 종류에 따라 보호 수준과 활용 조건이 달라진다”는 것이 2차 특강의 설명이었습니다. 이어서 많이 헷갈리는 두 낱말도 갈랐습니다.
이름 등 식별정보를 가명으로 처리. 추가 정보를 쓰면 개인을 알아볼 가능성이 있다.
시간 · 비용 · 기술을 합리적으로 고려할 때 개인을 알아볼 수 없도록 처리한 것.
센터는 바이오를 중심으로 설계되지만, “같은 계산을 수없이 되풀이한다”는 조건에 걸리는 작업은 분야를 가리지 않습니다. 제주그래퍼가 하는 네 가지 일을 예로 덧붙입니다. 네 가지가 따로 노는 것이 아니라, 찍고 → 재고 → 맞추고 → 쓰는 한 줄로 이어집니다.
멀티스펙트럴 드론은 사람 눈에 보이지 않는 파장(근적외선 등)까지 함께 찍습니다. 한 번의 비행으로 사진 수천 장을 찍고, 이것을 센티미터 단위 정사영상 한 장으로 합친 뒤 식생지수를 계산하고, 픽셀 한 칸 한 칸을 식물의 종류와 상태로 분류합니다.
사진 수천 장을 겹쳐 가며 한 장의 지도로
픽셀 수억 개마다 파장별 값으로 식생지수 계산
그 값을 학습된 기준에 대어 종류·상태로 분류
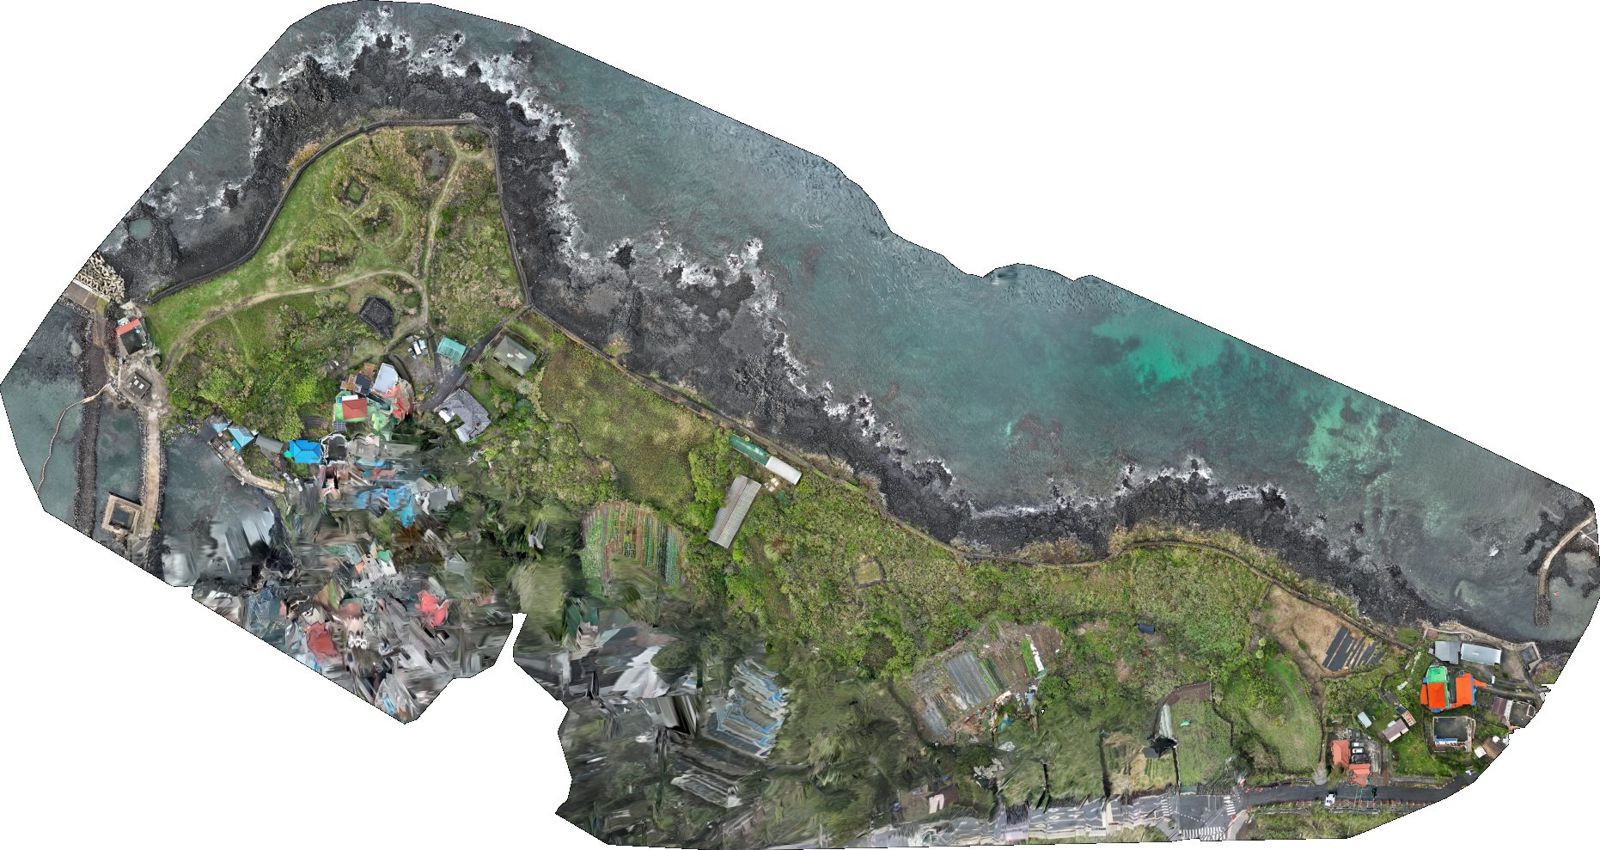
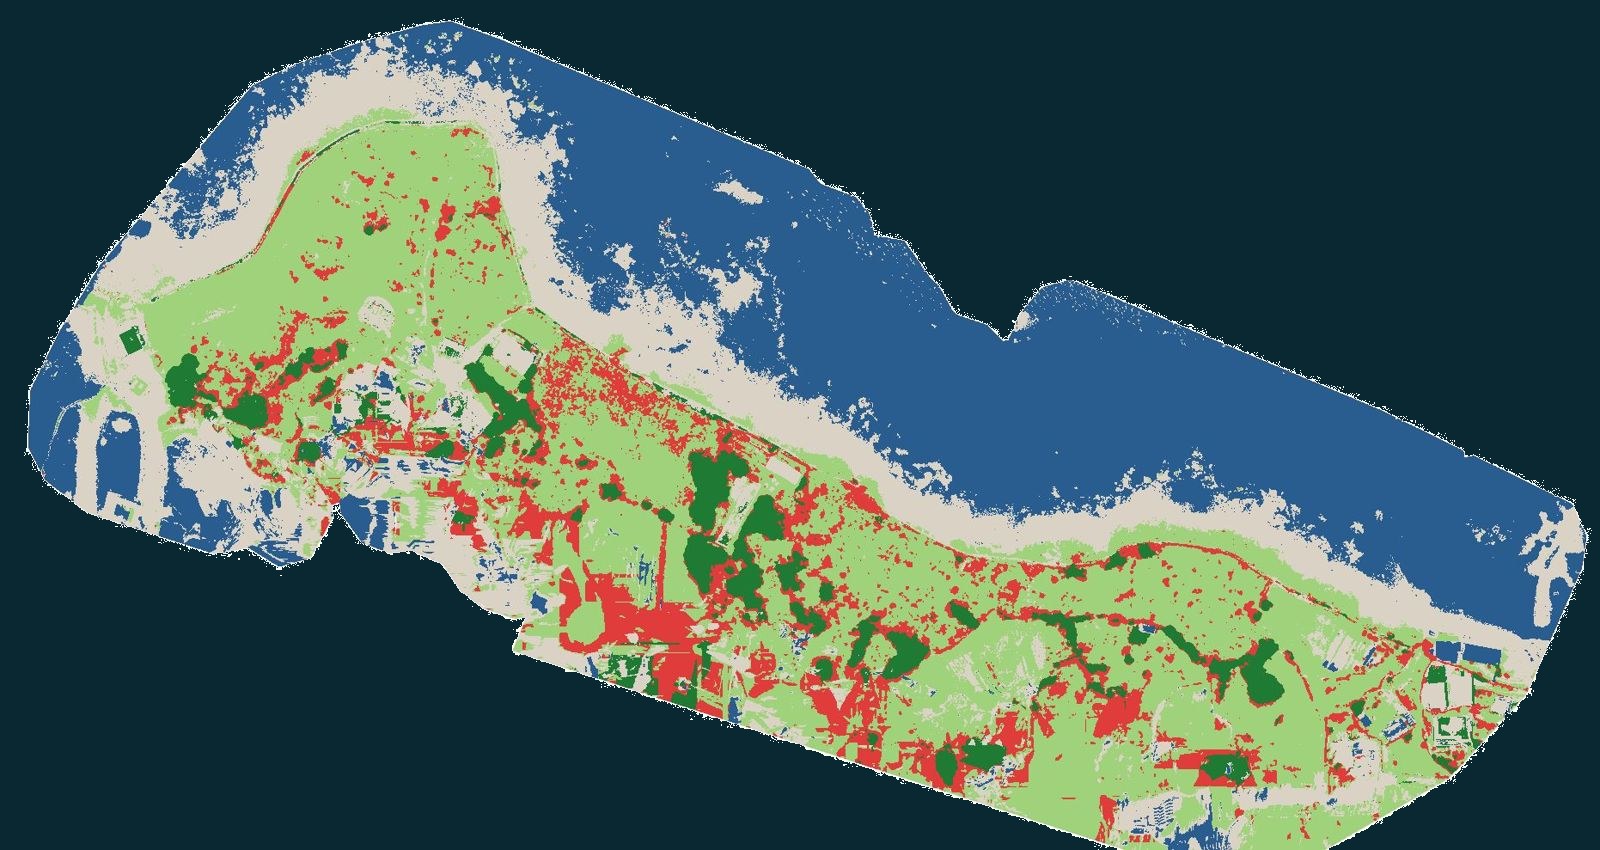
식물의 생육 상태를 데이터로 바꿔 판단한다 — 바이오기업이 하려는 일과 구조가 같습니다. 그리고 이 방식이 닿는 곳은 한 자리가 아닙니다.
자라는 속도와 잎의 활력을 지수로 재고, 철마다 쌓아 수확량을 가늠합니다
병해·수분 스트레스처럼 눈에 띄기 전의 변화를 파장 차이로 먼저 잡습니다
면적·경계·경사를 실측치로 — 보조금과 경작 계획의 근거가 됩니다
수종과 나무 높이, 숲의 밀도를 넓은 면적에서 한 번에 봅니다
모두 면적 × 촬영 횟수 × 픽셀당 계산으로 양이 불어나는 일입니다. 한 필지를 한 번 보는 것과, 한 지역을 철마다 보는 것은 필요한 장비가 다릅니다.
백록담, 성산일출봉, 용암동굴처럼 한 장에 담기지 않는 공간이 있습니다. 사진 수천 장에서 공간을 3D로 되살리는 작업은, 수백만 개의 점을 놓고 “이 각도에서 이렇게 보여야 하는데 안 맞네” → 조금 고치기를 수만 번 되풀이하는 일입니다. 2차 특강의 ‘간 맞추기 × 수만 번’과 구조가 같습니다.
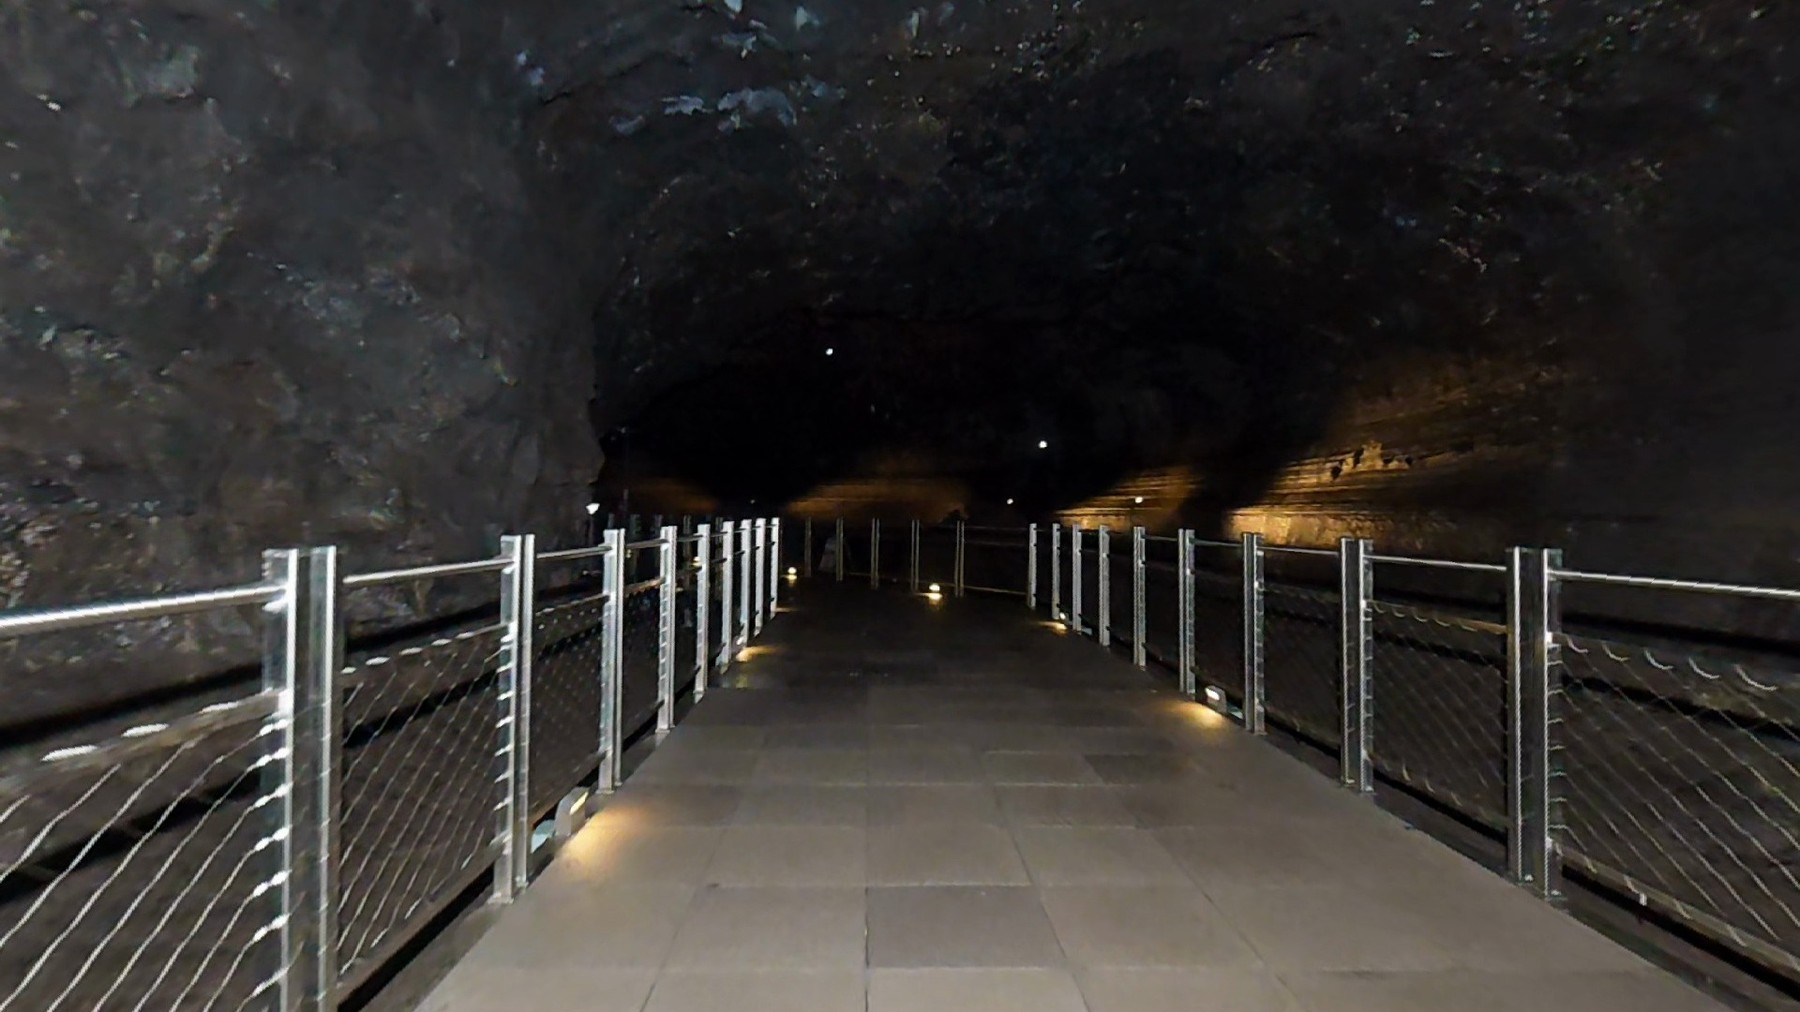
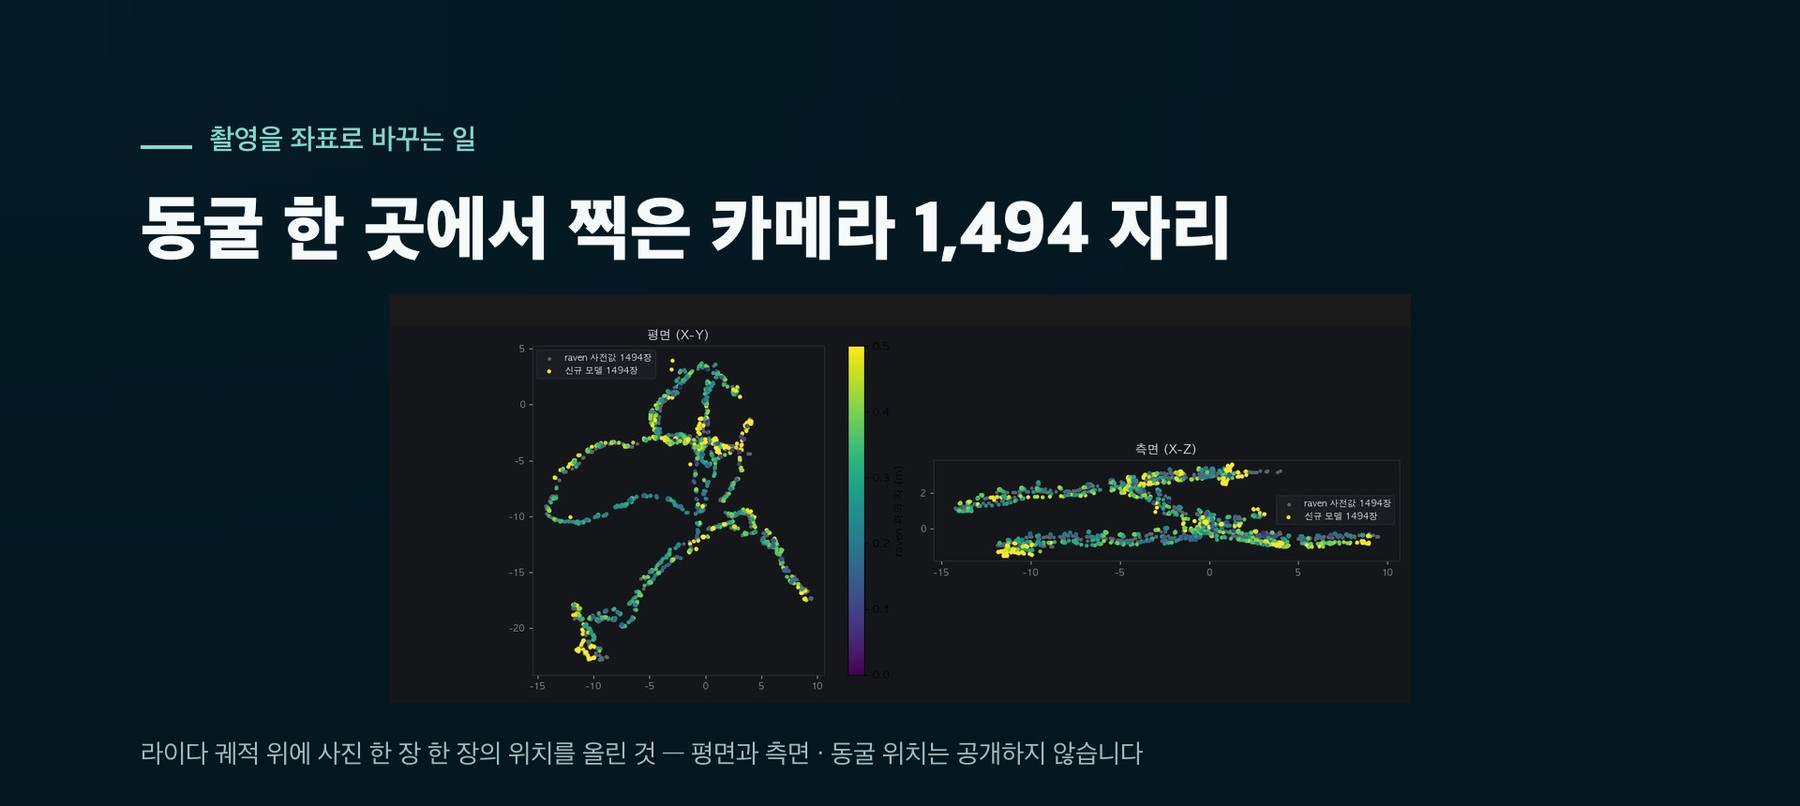
동굴 안에는 GPS 신호가 닿지 않습니다. 그래서 지하에서는 라이다로 걸어 들어간 궤적을 쌓고, 입구와 지상에서 잡은 기준점으로 그 궤적을 지상 측량 좌표에 올려 맞춥니다. 맞추고 나면 “이 통로가 지상의 어디 아래를 지나는지”, “천장까지 몇 미터인지”가 숫자로 나옵니다.
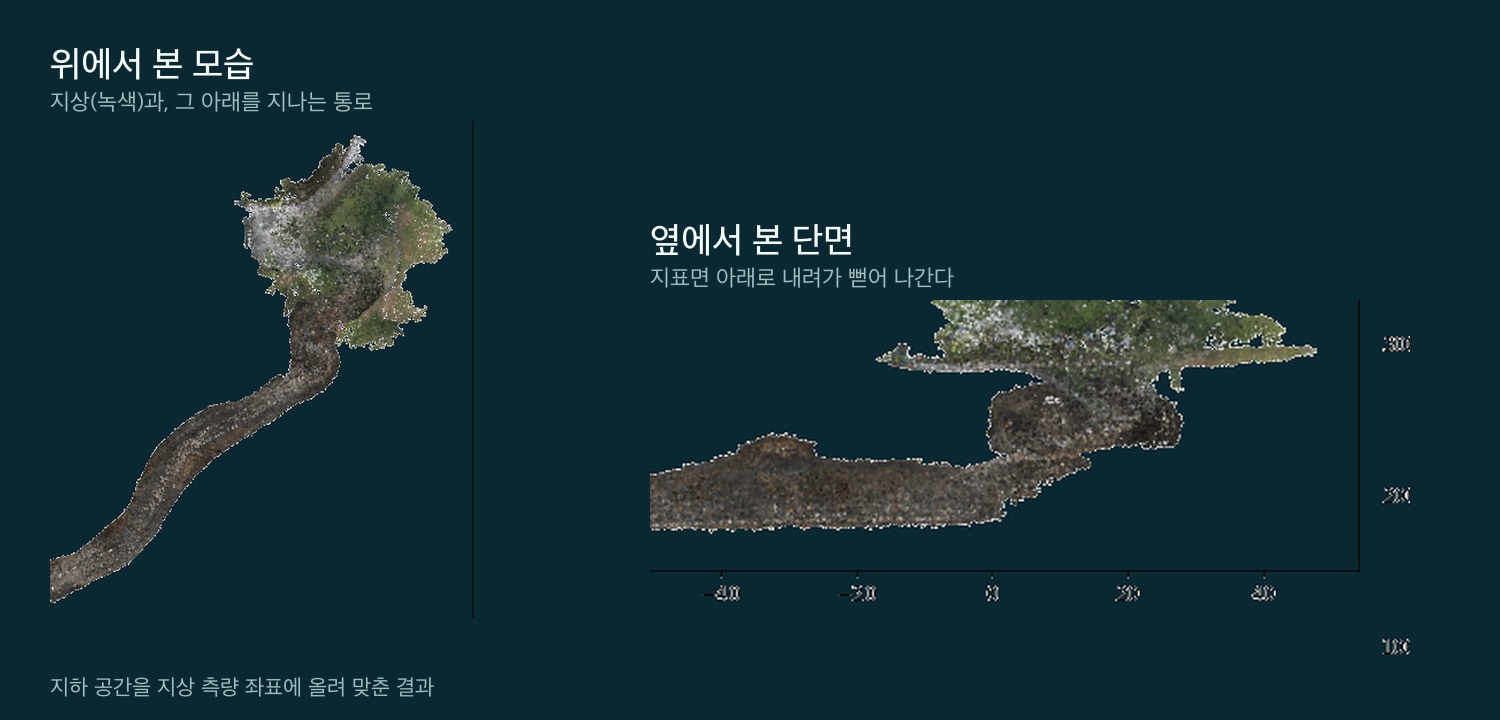
이 맞추는 계산도 반복입니다. 수천만 개의 점을 조금씩 돌리고 옮겨 가며 오차가 가장 작아지는 자리를 찾습니다. 공간이 길고 점이 많을수록 메모리가 먼저 모자랍니다.
초정밀로 되살린 공간은 보기만 하는 그림이 아닙니다. 점 하나하나에 실제 좌표가 붙어 있어서, 브라우저에서 직접 걸어 다니게 만들 수도 있고 거리·면적·천장고를 재는 도구로도 쓸 수 있습니다.
걸어 다니게 하려면 눈에 보이는 것만으로는 안 됩니다. 수백만 점에서 바닥 높이, 천장까지의 높이, 지나갈 수 있는 구역을 따로 계산해 내야 합니다. 이것도 전부 반복 계산입니다.
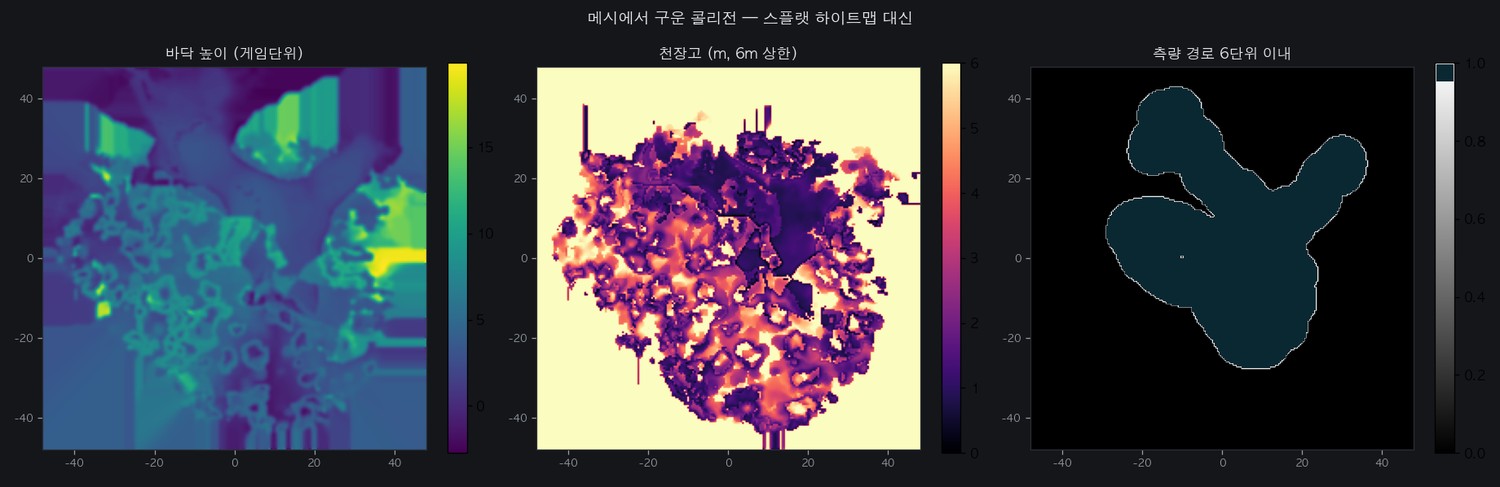
현장에 다시 가지 않고 거리·면적·천장고를 확인하고, 해마다 찍어 변화를 봅니다
출입이 어려운 곳을 브라우저에서 걸어 다니게 — 보존과 공개를 함께 풀 수 있습니다
네 가지 모두 TRACK 1(연산 자원)에 해당하는 일입니다. 데스크톱 한 대로는 메모리가 먼저 모자라고, 돌려도 며칠이 걸립니다. 센터가 생기면 지역에서 이런 일을 하는 쪽도 선택지가 하나 늘어납니다.
두 회차 모두 전체를 기록했습니다. 색과 밝기를 보기 편하게 맞추고, 사람 목소리는 살리되 과자봉지 · 의자 소리는 덜어냈습니다. 쉬는 시간과 대기 화면은 덜어 내고 강의 내용만 남겼습니다.
2026. 10. 22 (목) 16:00~18:00 · 1시간 48분 51초 · 기업이 AI를 어디에 쓸 것인가, 그리고 센터 소개와 질의응답
2026. 10. 26 (월) 16:00~18:00 · 1시간 29분 36초 · 이 페이지에 정리한 내용 대부분이 이 회차에서 나왔습니다
| 항목 | 지금 상태 |
|---|---|
| 위치 | 확정 — 제주대 후문 바이오센터 1호관 1층 |
| 규모 | 공개 — GPU 32장 · 스토리지 1.3PB · 폐쇄형 클라우드 서버 12대 · 286㎡(약 86평) |
| 일정 | 공개 — 2026년 12월 초 구축 완료 예정 |
| 서비스 방향 | 공개됐으나 ‘(안)’ — TRACK 1 컴퓨팅 자원 / TRACK 2 마켓플레이스 |
| 운영방식 | 미정 — 향후 운영계획에 따라 결정 |
| 이용조건 | 미정 — 〃 |
| 이용료 | 미정 — 〃 |
| 자원 배정방식 | 미정 — 〃 |